
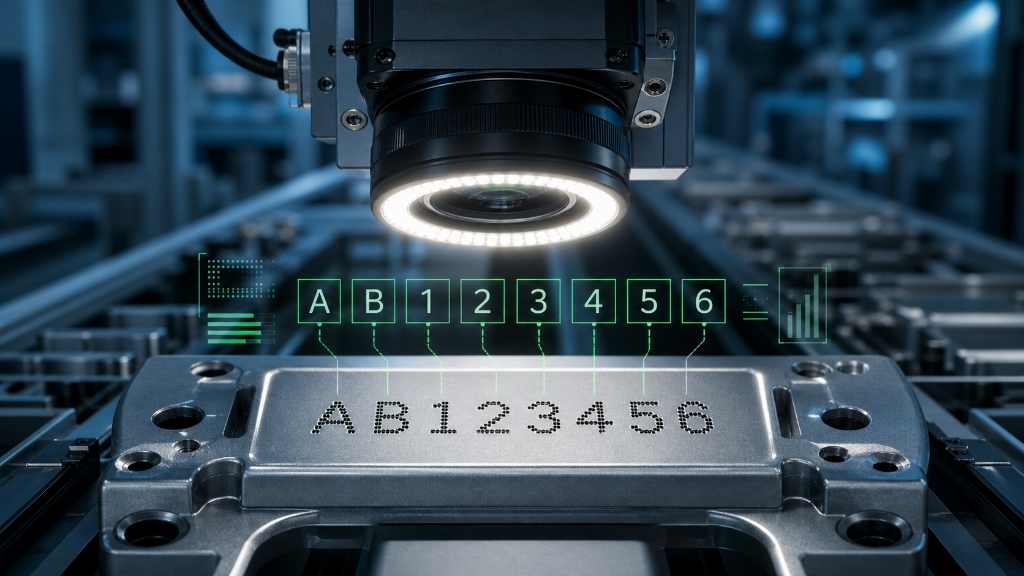
Каждая деталь на современном производстве должна иметь «паспорт» — серийный номер, код партии, дату изготовления или DataMatrix-код. Без этого невозможно проследить историю изделия, подтвердить качество или отозвать дефектную партию. Но считать маркировку в промышленных условиях — задача нетривиальная. Штрихкоды затираются, точечная маркировка на металле теряет контраст, этикетки повреждаются. Человек с ручным сканером тратит время, ошибается и становится узким горлышком.
На помощь приходит распознавание маркировки техническим зрением — системы оптического распознавания символов (OCR), которые позволяют роботам читать серийные номера, коды партий и другую информацию в реальном времени. В этой статье мы разберём, как работают OCR-системы для роботов, какие технологии используются, чем отличается классический OCR от глубокого обучения, и приведём реальные примеры внедрения на российских предприятиях.
Почему ручное считывание маркировки становится проблемой
На любом производстве есть участки, где нужно считать номер с детали, трубы, контейнера или упаковки. Традиционно это делают люди со сканерами или просто глазами. У этого подхода есть фундаментальные ограничения:
- Скорость. Человек физически не может обрабатывать тысячи деталей в час.
- Усталость и ошибки. При монотонной работе внимание падает, процент ошибок растёт. Особенно критично, когда детали отличаются «буквально в миллиметры».
- Условия съёмки. Маркировка может быть нанесена в труднодоступном месте, под плохим углом, с бликами.
- Качество маркировки. Точечная маркировка (dot peen) на металле, лазерная гравировка, штамповка — всё это сложно читается человеком при плохом освещении.
- Отсутствие цифрового следа. Человек прочитал — внёс в систему. Но кто проверит, что он не ошибся?
Распознавание маркировки техническим зрением решает все эти проблемы: высокая скорость, отсутствие усталости, объективность, полная цифровая прослеживаемость. Как показывает практика, автоматические системы идентифицируют более 95% продукции — уровень, недостижимый для человека в аналогичных условиях.
Что такое OCR и как он работает в промышленности
OCR (Optical Character Recognition) — технология распознавания печатных или рукописных символов. В промышленности OCR используют для чтения буквенно-цифровых маркировок: серийных номеров, кодов партий, сроков годности, VIN-номеров.
Классический OCR — правила и шаблоны
Традиционные OCR-системы работают по принципу сравнения символов с эталонными шаблонами. Камера делает снимок, изображение бинаризируется (превращается в чёрно-белое), каждый символ выделяется и сравнивается с библиотекой шрифтов.
- Плюсы: быстро, дёшево, работает на ограниченном наборе шрифтов.
- Минусы: если шрифт нестандартный, символ деформирован, есть блик или засвет — система «падает». Классический OCR не справляется с точечной маркировкой, где точки сливаются или имеют разный контраст.
OCR на основе глубокого обучения (Deep Learning OCR)
Современные системы распознавания маркировки используют нейросети. Вместо жёстких шаблонов — десятки тысяч размеченных изображений символов в разных условиях. Нейросеть обучается понимать, что такое «цифра 5» даже если она нанесена точками, смазана или частично стёрта.
- Плюсы: работает на сложных поверхностях, деформированных символах, с бликами и плохим контрастом.
- Минусы: требует данных для обучения, дороже в разработке.
Глубокое обучение особенно эффективно для сложных типов маркировки, таких как Direct Part Marking (DPM) — точечная, лазерная или ударная маркировка непосредственно на металлических деталях.
Типовая система OCR для роботов включает несколько компонентов.
Аппаратная часть
- Камера — промышленная камера с высоким разрешением и глобальным затвором для съёмки движущихся объектов.
- Освещение — направленный свет, подобранный под тип поверхности (кольцевой, коаксиальный, структурированный) для устранения бликов.
- Вычислительный модуль — промышленный компьютер или встроенный процессор для обработки изображений. В некоторых решениях используется смарт-камера, объединяющая сенсор и вычислитель.
- Интерфейсы — Ethernet/IP, Profinet, Modbus TCP для передачи результатов в систему управления.
Программная часть
- Детектор текста — нейросеть находит на изображении область, где находится маркировка. Используются архитектуры вроде YOLO или U-Net.
- OCR-движок — распознаёт символы в найденной области. Популярные движки: Tesseract, PaddleOCR, а также проприетарные решения от Cognex, Keyence, Roboflow.
- Постобработка — проверка контрольной суммы, валидация формата, сравнение с базой данных.
Основные типы маркировки и их особенности
| Тип маркировки | Способ нанесения | Сложность для OCR | Где применяется |
| Печатный текст | Струйная печать, термотрансфер | Низкая — чёткие символы на контрастном фоне | Этикетки, упаковка, штрихкоды |
| Штамповка | Механическое выдавливание | Средняя — рельефные символы, тени | Металлические таблички, корпусные детали |
| Лазерная гравировка | Лазерное выжигание | Средняя — контраст зависит от материала, возможны блики | Электронные компоненты, инструмент |
| Точечная маркировка (DPM) | Пневматический удар точками | Высокая — точки могут сливаться, имеют разный контраст | Металлические детали в автопроме, авиации |
| Ударная маркировка | Механический удар | Высокая — деформация металла, сложные тени | Трубы, крупные заготовки |
| Контейнерные номера | Трафарет, наклейки | Средняя — устойчивость к загрязнениям и потертостям | Логистика, порты |
Примеры из практики
Пример 1. АвтоВАЗ — контроль VIN-кодов на конвейере
Задача: На тольяттинском конвейере АвтоВАЗа требуется проверять наклейки с VIN-номером на кузове автомобиля — корректность данных, отсутствие несоответствий, целостность наклейки. Повреждённая или нечитаемая маркировка создаёт проблемы при постановке на учёт в ГИБДД.
Решение: Внедрена интеллектуальная система распознавания на базе технологий компьютерного зрения от российского разработчика VisionLabs. Система выполняет две ключевые функции: сравнивает данные с наклейки и гравировки с VIN-номером, а также проверяет качество самой наклейки.
Результаты: Пилотный режим запущен на моделях Lada Aura и Lada Vesta. В планах — масштабирование на другие модели.
Задача: На Северском трубном заводе (СТЗ, входит в ТМК) трубы перемещаются и складируются, их маркировка может быть не читаема вручную. Требовалась система автоматической идентификации в производственном потоке.
Решение: Внедрена система из камеры с направленным освещением и вычислительного модуля. Нейросети обрабатывают серию кадров, определяют наилучшие и распознают маркировку. Для повышения качества на трубы наносится маркировка с контрольной суммой — система оценивает точность распознавания.
Результаты: Более 95% продукции успешно идентифицировано в автоматическом режиме. Система внедрена в промышленную эксплуатацию.
Пример 3. КАМАЗ — идентификация деталей в окрасочном цехе
Задача: На прессово-рамном заводе КАМАЗа детали поступают в окрасочный цех в таре с биркой, но после окраски идентификация теряется. Готовый продукт мог находиться в зоне съёма до пяти-шести часов в ожидании, пока сотрудники определят, что это за изделие. Детали могли отличаться буквально в миллиметры.
Решение: Разработана система технического зрения, которая фиксирует деталь, определяет её номенклатуру и помогает правильно распределить после конвейера. Также создано мобильное приложение для распознавания деталей через смартфон.
Результаты: Исключена пересортица деталей, простой конвейера сведён к минимуму. Первая стадия проекта — тестирование — завершена.
Пример 4. Производитель автокомпонентов — чтение точечной маркировки на корпусах
Задача: Поставщик автокомпонентов наносит точечную маркировку (dot peen) на алюминиевые корпуса для двигателей. Маркировка содержит серийный номер и код партии. Ручное считывание — медленно, ошибки до 3%.
Решение: Интеграция системы технического зрения с Deep Learning OCR на базе сверточной нейросети. Камера с коаксиальной подсветкой установлена на роботе. Система обучена на 10 000 изображений точечной маркировки в разных условиях освещения.
Результаты: Скорость считывания — 60 деталей в минуту. Точность распознавания — 99,2%. Полная прослеживаемость каждой детали в системе MES. Окупаемость — 9 месяцев.
Выбор между OCR и штрихкодом — что лучше
| Параметр | OCR (текст) | Штрихкод / QR-код |
| Человекочитаемость | Да — текст виден и понятен людям | Нет — требуется сканер |
| Устойчивость к повреждениям | Средняя — если часть символов стёрта, нейросеть может дочитать по контексту | Низкая — повреждение 20–30% кода делает его нечитаемым |
| Объём информации | Ограничен длиной строки | QR-код может хранить до 4 296 символов |
| Скорость распознавания | 0,05–0,5 секунды на символ | Мгновенно (декодирование за 0,08 секунды) |
| Сложность внедрения | Выше — требуется обучение нейросети | Ниже — готовые библиотеки декодирования |
| Стоимость | Выше — нужно ПО для OCR | Ниже — стандартные декодеры |
Когда выбирать OCR:
- Требуется человекочитаемая маркировка (инспекторы, клиенты).
- Маркировка нанесена непосредственно на деталь (DPM).
- Штрихкод невозможно нанести из-за ограничений поверхности.
Когда выбирать штрихкод/QR:
- Большой объём данных (до 4 000 символов).
- Высокая скорость считывания.
- Бюджетное решение.
Точность OCR — что можно гарантировать
Точность распознавания зависит от множества факторов: качества маркировки, условий съёмки, сложности шрифта, объёма обучающих данных.
| Тип маркировки | Классический OCR | Deep Learning OCR |
| Чёткий печатный текст на контрастном фоне | 98–99% | 99,5%+ |
| Штамповка на металле | 85–90% | 96–98% |
| Точечная маркировка (DPM) | 60–75% | 95–99% |
| Лазерная гравировка на пластике | 90–95% | 97–99% |
| Загрязнённая / повреждённая маркировка | <50% | 85–95% |
Важно: 100% точность недостижима. Но при правильном обучении и достаточном объёме данных Deep Learning OCR значительно превосходит человека — особенно в скорости и отсутствии усталости.
Ограничения и когда OCR не работает
- Экстремально низкий контраст. Если символы почти сливаются с фоном (например, светлая гравировка на светлом металле), даже нейросеть может не справиться. Требуется специальное освещение.
- Сильная деформация символов. При точечной маркировке на неровной поверхности точки могут «расплываться» — нейросеть должна быть обучена на таких примерах.
- Отсутствие данных для обучения. Для Deep Learning OCR нужно не менее 5 000–10 000 размеченных изображений. Сбор и разметка — дорого и долго.
- Высокая скорость движения. Если деталь движется быстрее 5 м/с, может потребоваться стробоскопическая подсветка и камера с глобальным затвором.
- Сложный многострочный текст. OCR легче читает одну строку. Многострочные надписи требуют дополнительной обработки.
- Нестандартные шрифты. Если маркировка выполнена уникальным шрифтом, систему нужно дообучать.
Экономика проекта — сколько стоит и когда окупается
| Статья затрат | Диапазон, млн руб. | Примечания |
| Камера и оптика | 0,2–1,0 | Зависит от разрешения и типа |
| Освещение | 0,1–0,5 | Кольцевое, коаксиальное, структурированное |
| Промышленный компьютер / смарт-камера | 0,3–1,5 | С GPU для нейросетей |
| ПО для OCR (лицензия) | 0,3–2,0 | Cognex, Keyence, Roboflow, OpenCV |
| Сбор и разметка данных | 0,3–1,5 | Самый трудоёмкий этап |
| Разработка и обучение нейросети | 0,3–1,5 | Зависит от сложности |
| Интеграция и пусконаладка | 0,3–1,0 | Подключение к линии, обучение |
| Итого (типовой проект) | 1,8–9,0 | Зависит от сложности |
Окупаемость складывается из:
- Снижения ручного труда (замена 1–3 операторов на линии).
- Устранения ошибок идентификации (пересортица, отправка не той детали).
- Полной прослеживаемости (доказательство качества заказчику).
- Сокращения простоев конвейера.
Типовой срок окупаемости: от 6 до 18 месяцев.
Риски и как их минимизировать
| Риск | Последствия | Минимизация от ВТ-Роботикс |
| Недостаточно данных для обучения | Низкая точность, ложные срабатывания | Используем аугментацию данных, синтетическую генерацию, предобученные модели (omnifont) |
| Изменение типа маркировки | Модель перестаёт работать | Проектируем систему с возможностью быстрого дообучения (fine-tuning) |
| Плохое освещение | Камера «не видит» символы | На этапе проектирования подбираем оптимальный тип освещения |
| Загрязнение оптики | Падение качества изображений | Устанавливаем защитные стёкла с продувкой, регламент очистки |
| Высокая частота ложных срабатываний | Операторы перестают доверять системе | Настраиваем порог уверенности, внедряем двухэтапную верификацию |
| Интеграция с MES/ERP | Данные не передаются в учётную систему | Закладываем интеграционные интерфейсы на этапе проектирования |
Рекомендации по внедрению OCR для роботов
- Начинайте с простого — с печатной маркировки на контрастном фоне. Это самый быстрый способ получить результат.
- Соберите репрезентативную выборку символов. Не менее 50–100 изображений каждого символа в разных условиях (освещение, угол, состояние поверхности).
- Используйте предобученные модели. Современные Deep Learning OCR-движки (Cognex Deep Learning, Roboflow Industrial OCR) имеют встроенные библиотеки шрифтов и требуют минимального дообучения.
- Не экономьте на освещении. Правильный свет — 80% успеха OCR. Для металлических поверхностей используйте коаксиальную или кольцевую подсветку.
- Тестируйте на реальных деталях. Привезите 20–30 образцов с маркировкой — разного качества, с разной степенью износа.
- Внедряйте контрольную сумму. Если маркировка содержит проверочный символ — система может автоматически верифицировать результат.
- Обучите персонал. Оператор должен понимать, как интерпретировать ошибки системы и когда вмешиваться.
- Планируйте дообучение. Технология маркировки может меняться — модель нужно будет обновлять.
Заключение
Распознавание маркировки техническим зрением — это зрелая технология, которая уже работает на российских предприятиях: АвтоВАЗ читает VIN-коды, Северский трубный завод идентифицирует трубы с точностью более 95%, КАМАЗ распознаёт детали в окрасочном цехе. Современные Deep Learning OCR-системы справляются с точечной маркировкой, штамповкой и лазерной гравировкой на сложных поверхностях.
OCR для роботов — это не только скорость и точность, но и полная цифровая прослеживаемость, выполнение требований заказчиков и снижение рисков. Вопрос уже не «стоит ли внедрять», а «как быстро вы начнёте».
Хотите оценить, как OCR может улучшить идентификацию на вашем производстве? Пришлите нам 20–30 фотографий маркировки с вашего завода. Мы проведём экспресс-анализ и скажем, какой уровень точности достижим для вашей задачи.